Préparation et mise en forme des données
Un exemple
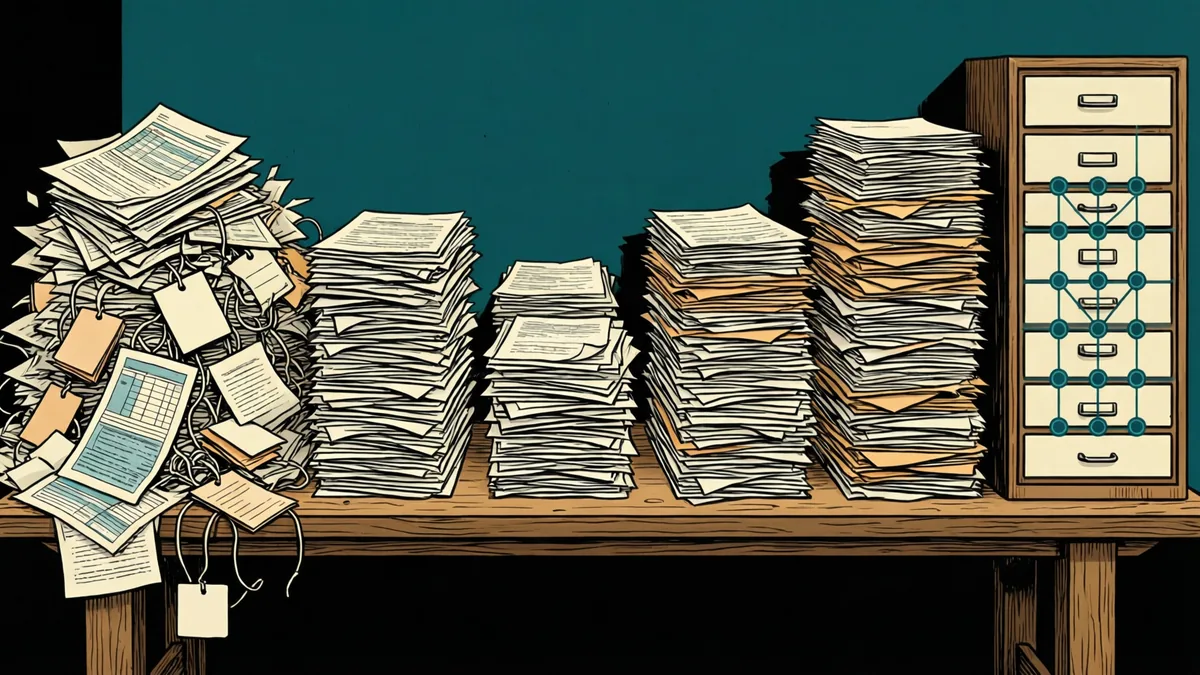
Voici un petit export de commandes tel qu'il arrive souvent : les mêmes personnes et entreprises écrites de différentes manières, des dates dans quatre formats et une ligne en double.
| Client | Organisation | Date | Produit |
|---|---|---|---|
| SMITH, JOHN | acme corp. | 3/4/24 | widget-A |
| john smith | ACME Corporation | 2024-03-04 | Widget A |
| Maria Garcia | Acme Corp | March 5 2024 | WIDGET b |
| Lee, Ana | northwind | 2024/03/06 | widget-a |
Après préparation, les noms, les organisations, les dates et les produits ont chacun une forme cohérente, et la commande en double est fusionnée.
| Client | Organisation | Date | Produit |
|---|---|---|---|
| John Smith | Acme Corporation | 2024-03-04 | Widget A |
| Maria Garcia | Acme Corporation | 2024-03-05 | Widget B |
| Ana Lee | Northwind Traders | 2024-03-06 | Widget A |
Graphes de connaissances
Un graphe de connaissances stocke l'information sous forme d'éléments et de liens entre eux, plutôt que sous forme de lignes dans des tables séparées. Une fois les données nettoyées, les mêmes commandes deviennent un petit graphe de personnes, des organisations pour lesquelles elles travaillent et des produits qu'elles ont commandés.
Les liens du graphe :
- John Smith travaille chez Acme Corporation et a commandé Widget A.
- Maria Garcia travaille chez Acme Corporation et a commandé Widget B.
- Ana Lee travaille chez Northwind Traders et a commandé Widget A.
Des questions auxquelles il était difficile de répondre à partir de l'export brut deviennent simples : Widget A est commandé par des clients de deux organisations différentes, et Acme Corporation achète les deux produits. Des graphes de ce type fournissent aussi à la recherche et aux systèmes d'ASI des faits exacts et connectés sur lesquels s'appuyer.
Ce que nous faisons
- Nettoyage et normalisation de feuilles de calcul, de CSV, de JSON et de XML
- Conversion entre formats, notamment Word, PDF, HTML, Markdown et données structurées
- Dédoublonnage et rapprochement des enregistrements qui désignent la même personne, la même organisation ou le même élément
- Graphes de connaissances construits à partir de vos documents et de vos dossiers
- Conception et validation de schémas, pour que les flux de données récurrents restent propres
- Préparation de documents et de jeux de données pour la recherche, la récupération d'information et les systèmes d'ASI
- Génération IMS Common Cartridge (IMSCC) et assistance pour les packages de cours numériques, élaborés à partir de vos supports de cours existants et prêts à être importés dans votre système de gestion de l'apprentissage
Des livrables accessibles dès la conception
Un contenu bien structuré est un contenu accessible. Lorsque nous convertissons des documents, le résultat comporte de véritables titres, un ordre de lecture logique, des tableaux dotés d'en-têtes appropriés et des descriptions pour les images, de sorte qu'il fonctionne avec les lecteurs d'écran et les autres technologies d'assistance, sans projet de mise en conformité distinct.
Comment cela fonctionne
- Partagez un échantillon. Un extrait représentatif de vos données nous montre à quoi nous avons affaire.
- Convenez de la cible. Nous définissons ensemble le format propre et documentons les règles.
- Traitement et vérification. Nous préparons l'ensemble complet et le contrôlons au regard des règles convenues.
- Répétez au besoin. Pour les données récurrentes, nous pouvons livrer le processus sous forme de logiciel que vous exécutez vous-même.
Nous pouvons réaliser ce travail entièrement sur des machines locales, afin que vos données n'aient jamais à être envoyées à un service extérieur.